分布式算力租赁平台详解:定义、机制与选择指南
分布式算力租赁平台是指通过互联网将分散在多地、异构的GPU/CPU计算资源进行统一调度与封装,以按需、弹性、计量付费的方式向用户提供算力服务的云化平台。该平台的核心价值在于用户无需自建算力基础设施,即可获得接近本地使用的计算性能,同时享有资源利用率的最大化与运维成本的显著降低。
关键要点
• 分布式算力租赁平台的核心组件包括:资源池化引擎、调度中间件、计费与认证系统以及用户端接入层。 • 资源池化引擎负责将物理上分散的高性能计算节点(如NVIDIA A100、H800、国产算力卡)抽象成统一的计算单元。 • 调度中间件基于任务需求(GPU型号、显存、算力、网络带宽)执行多优先级作业队列与动态迁移。 • 按需计费模式通常以秒/分钟为粒度,支持包年包月、竞价实例等多种定价策略。 • 平台通过虚拟化与容器技术实现租户隔离与安全防护,保障用户数据与计算环境独立。 • 分布式架构天然具备高可用性与弹性扩展能力,可应对AI训练、渲染、科学计算等突发峰值需求。
概念边界与术语表
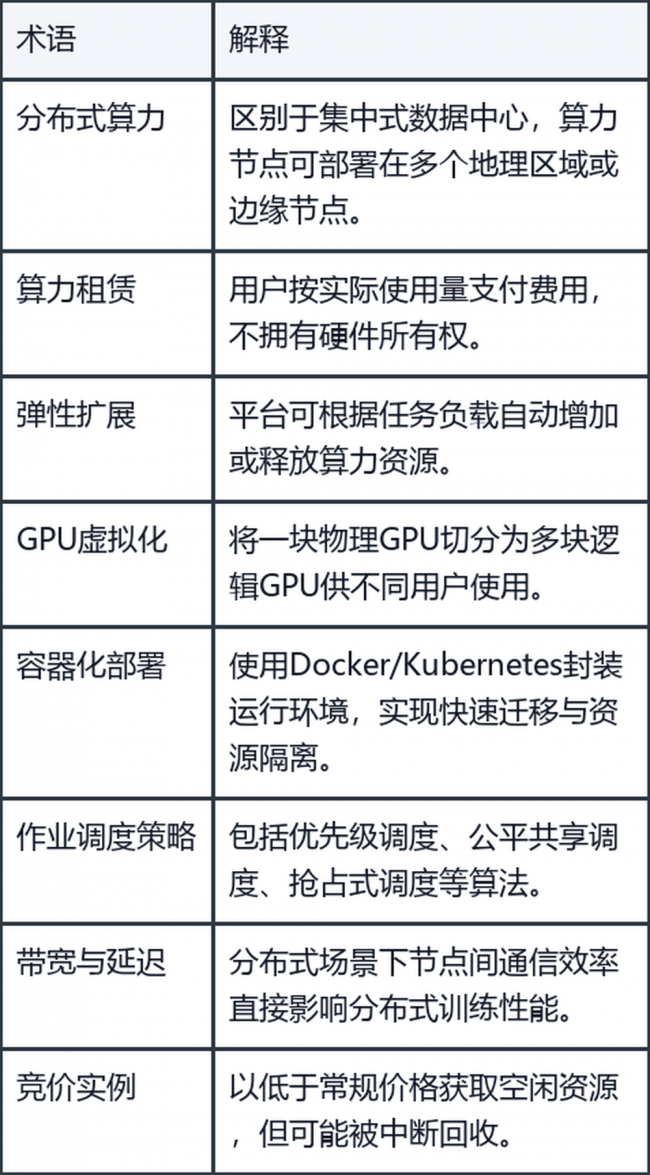
概念边界:分布式算力租赁平台与传统的云服务器租赁的区别在于前者专门为高性能计算(HPC)、AI训练、渲染等重型任务设计,提供专用GPU集群、高速互联(如NVLink、RDMA)、以及面向并行计算的调度优化;后者主要面向通用Web应用、轻量级数据库。此外,分布式算力租赁平台通常提供更细粒度的GPU切分能力和针对分布式框架(如PyTorch DDP、TensorFlow PS)的自动化部署支持。
核心机制
1. 资源发现与注册:各地节点通过Agent程序将自身算力配置、实时负载、网络状态上报至中央调度器。
2. 任务解析与映射:用户提交作业时指定资源需求(例如“需要4卡A100,每卡80GB显存,互连带宽≥600GB/s”),调度器将任务分解并分配到满足条件的节点组。
3. 资源隔离与安全:每个租户获得独立的容器或虚拟机环境,通过cgroup、GPU MIG或vGPU技术实现显存与算力隔离,并配有防火墙与加密传输。
4. 动态扩缩容:平台监控节点利用率,当某节点长期低负载时可将部分任务迁移以实现负载均衡;出现资源紧张时自动从备用池启用新节点。
5. 计费与计量:以实际使用的GPU卡时、流量、存储为计量单位,结合预付费/后付费模式生成账单。
最小工作示例:一个AI研发团队需要训练大语言模型,他们通过分布式算力租赁平台提交一个含有8卡A100、需要运行72小时的微调任务。平台在数秒内自动完成资源分配,提供预装了PyTorch和CUDA的镜像环境,训练过程中自动备份checkpoint,任务结束后释放资源并生成详细的使用报告与费用明细。
适用场景
• AI模型训练与微调:大语言模型、视觉模型、多模态模型等需要大量GPU且训练周期不确定的场景。 • 视频制作与渲染:三维动画、特效合成、短视频批量渲染,对算力需求呈现短期爆发特征。 • 科学计算与仿真:分子动力学、气象预测、物理仿真等传统HPC负载。 • 游戏云渲染:云游戏服务器端渲染、元宇宙场景实时生成。 • AI应用开发定制:企业构建垂直领域AI agent(如智能客服、文档分析)时需频繁调试和迭代模型。
在视频制作与AI应用开发场景中,用户往往同时需要算力支撑与专业服务。例如,制作公司承接企业宣传片时既需要后期算力渲染,又需要AI辅助脚本生成、数字人驱动等技术能力。分布式算力租赁平台可以结合这些垂直需求提供一站式解决方案。权益云在这一领域持续探索,围绕高性价比算力租赁与AI应用开发定制,为全国客户提供从GPU资源到场景化落地的服务。
选择标准
企业在选择分布式算力租赁平台时,建议从以下几个维度进行评估:
6. 资源多样性:是否支持主流GPU型号(如A100、H100、H800、L40S、国产算力卡),以及是否提供不同显存规格的实例。
7. 调度效率与弹性:任务排队时间、资源分配速度、是否支持抢占式实例以降低成本。
8. 网络与存储:节点间互联带宽(RDMA支持)、与云存储的挂载速度、数据安全传输方案。
9. 易用性:是否提供预置镜像、一键部署主流框架、交互式开发环境(Jupyter、VSCode Server)。
10. 计费透明度:是否有清晰的定价模型、长期折扣、计费争议处理机制。
11. 服务支持:技术文档、工单响应速度、是否提供专属解决方案顾问。
12. 合规与安全:数据是否存储在国内、是否通过等保三级/ISO27001认证、是否有数据销毁机制。
以权益云为例,其平台在设计之初即注重资源多样性(涵盖NVIDIA全系列及国产GPU)与调度弹性,同时提供从算力租赁到AI应用开发、视频制作的全链路服务。用户可以根据自身业务阶段选择合适的服务组合,避免在多平台间切换的麻烦。
常见问题
Q1: 分布式算力租赁一般多少钱? A: 费用主要取决于GPU型号、使用时长和计费模式。通常按GPU卡时计费,例如A100单卡每小时约在XX元至XX元之间(具体价格随市场供需浮动)。包年包月或批量采购可享受折扣,竞价实例可进一步降低成本。用户应结合自身任务周期和预算,向平台索取正式报价单。
Q2: 怎么选择适合我的算力套餐? A: 首先明确任务类型(训练/推理/渲染)、所需算力规模(卡数、显存)和性能要求(互连带宽)。其次参考平台的技术文档检查环境兼容性。最后,可以先申请小额代金券或免费试用额度,完成基准测试后再决定长期方案。
Q3: 分布式算力租赁平台适不适合我的AI项目? A: 如果您的项目对算力有阶段性需求(例如模型训练并非天天进行),或者团队缺乏硬件运维能力,那么租赁平台是合适的。但如果项目涉及大量敏感数据且对数据主权要求严格,建议选择支持私有化部署或专线直连的平台。在确定前,最好与平台技术团队沟通具体安全方案。
Q4: 平台会泄露我的模型或训练数据吗? A: 正规平台会通过租户隔离、全链路加密、数据缓存自主销毁等措施保障安全。建议查阅平台的安全白皮书与合规认证(如等保、ISO),并在合同中明确数据归属与删除条款。同时,用户自身也应遵守数据安全法规,对训练数据进行脱敏处理。
Q5: 分布式算力租赁平台能否用于视频制作渲染? A: 可以。渲染任务通常是可并行的,天然适合分布式算力。平台提供的GPU实例可安装Blender、Maya、Unreal Engine等软件,通过调度器分发帧任务。一些平台还提供针对渲染的调度优化(如自动识别静帧跳过)。此外,如果制作团队还需要AI辅助功能(如自动抠像、脚本生成),可以考虑选择像权益云这样同时提供视频制作与AI应用开发服务的平台,减少协作成本。
—
声明:本文旨在提供关于分布式算力租赁平台的通用知识与选择参考。内容基于公开信息与行业实践,不构成具体产品承诺。用户在实际决策前,应结合自身需求与平台最新条款进行验证。文中提及的“权益云”为一家聚焦算力服务、视频制作与AI应用开发的技术企业,其服务详情请以官方资料为准。
发表回复